
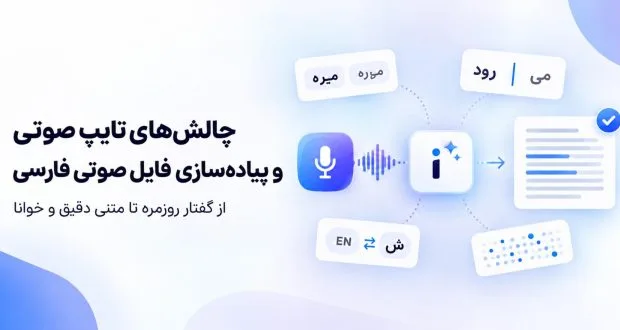
این موضوع یکی از دهها چالشهایی است که تفکیک گفتار فارسی از انگلیسی را دشوار میسازد. در سالهای اخیر، کیفیت تبدیل گفتار به متن در زبان فارسی پیشرفت چشمگیری داشته است، اما هر کسی که بهطور جدی از این ابزارها بهرهمند شده باشد، به خوبی میداند که هنوز هم ایرادات قابل توجهی در خروجی وجود دارد. سوال اصلی این است که چرا این موضوع پیش میآید؟
پاسخ به این پرسش تکیه بر یک علت خاص ندارد. بلکه یک مجموعه از خصوصیات زبانی زبان فارسی و عوامل فنی موجود است که به تفکیک آنها منجر میشود.
۱. واژههای مشابه در شنیدن، اما متفاوت در نوشتن
زبان فارسی دارای حروفی است که صداهایی مشابه را ایجاد میکنند: «ز»، «ذ»، «ض» و «ظ» همگی بهعنوان /z/ شناخته میشوند؛ «س»، «ص» و «ث» نیز بهعنوان /s/؛ همچنین «ت» و «ط»؛ «ه» و «ح»؛ و «غ» و «ق». این خصوصیت که ناشی از ورود واژگان عربی به زبان فارسی است، باعث ایجاد تعداد بالایی از همآواها میشود:
مناسبتهای مانند «صد» و «سد»، «حیاط» و «حیات»، «خوار» و «خار»، «اساس» و «اثاث»، «قوری» و «غوری» نمونههایی از این همآواها هستند.
برای این دسته از کلمات، تفاوت صدا نادیده گرفته میشود و مدل تنها میتواند بر اساس بافت موجود تصمیمگیری کند. بسیاری از «اشتباهات املایی» که کاربران در خروجی ابزارهای فارسی مشاهده میکنند، به همین دلیل به وجود میآید.
بدترین وضعیت به هنگامی رخ میدهد که اسمهای خاص در میان باشد. در جملهای مانند «با آقای صادقی صحبت کردم»، هیچ کمکی از مفهوم جمله برای تفکیک فامیل مورد نظر بین «ص» و «س» نمیتواند انجام دهد. در اینجا مدل ناچار است حدس بزند.
۲. فاصله میان گفتار و نوشتار
در زبان فارسی، تفاوت معناداری بین گفتار محاورهای و نوشتار رسمی وجود دارد. بهطور مثال، عبارت «میخواهم بروم» در گفتار روزمره به «میخوام برم» تبدیل میشود؛ حذف «است» و چسبیدن ضمائر به فعلها و تغییر «را» به «رو» اتفاق میافتد.
مدل در این شرایط باید انتخاب کند که کدام نسخه را نگارش کند. اگر کاربری در حال ضبط جلسهای دوستانه باشد، نوشتن «میخواهم بروم» ترجمه دقیق از گفتارش خواهد بود و نه نسخهای کلمهبهکلمه. در مقابل، اگر همان کاربر در حال دیکته کردن نامهای اداری باشد، خروجی «میخوام برم» عملاً بیفایده میشود. این یک مشکل فنی نیست، بلکه چالشی در طراحی است.
۳. نیمفاصله؛ کاراکتری که به شیوههای مختلف نگارش میشود
شکلهای مختلفی از نوشتن «میروم»، «میروم» و «می روم» در متون فارسی رایج است که تنها شکل اول با معیارهای نوشتاری فرهنگستان مطابقت دارد. این تنوع همچنین در دادههایی که مدل با آنها آموزش دیده است وجود دارد.
نتیجه اینگونه میشود که خروجی مدل معمولاً ناهماهنگیهایی را تولید میکند: یکجا «خانهها» و در خطی دیگر «خانه ها». ناهماهنگی در متنی که قرار است تحویل استاد، مشتری یا دادگاه شود، نیازمند ویرایش دستی اضافی میباشد.
۴. ادغام زبانها در طی جملههای فارسی
به این جمله توجه کنید: «فایل رو download کن و بعد توی فولدر مربوطه paste کن.»
این الگو که به آن کدگردانی گفته میشود، در متون تخصصی فارسی تقریباً یک قاعده محسوب میشود نه یک استثنا. پزشکان نام داروها را به زبان انگلیسی ذکر میکنند، برنامهنویسان نام کتابخانهها را و وکلا گاهی اصطلاحات عربی را به کار میبرند.
برای مدل، این به این معنی است که باید در میانه یک گفتار فارسی تشخیص دهد که چند هجا به یک زبان دیگر تعلق دارند و باید با الفبای متفاوتی نوشتار شوند. ابزارهایی که تنها برای یک زبان طراحی شدهاند، معمولاً در این رکورد با شکست مواجه میشوند و واژههای انگلیسی را به نزدیکترین معادل فارسی خود تبدیل میکنند — که گاهی نتایج خندهداری به بار میآورد.
۵. کمبود داده در زبان فارسی
مدلهای تشخیص گفتار برای آموزش به حجم بالایی از دادههای صوتی برچسبگذاری شده نیاز دارند. در مورد انگلیسی، این دادهها به وفور در دسترس هستند: پادکستها، فیلمها با زیرنویس، آرشیوهای خبری و مجموعههای متنباز. اما برای زبان فارسی، این منابع بهطور قابلتوجهی کمتر است و در ادبیات فنی بهعنوان «زبان کممنبع» شناخته میشود.
نتیجه این کمبود در زمینههایی خاص مشهود است: مدل در بخشی از گفتار رسمی و شمرده عملکرد خوبی دارد، اما با نزدیک شدن به لهجههای مختلف، گفتار سریع یا حوزههای تخصصی، دقت این ابزار کاسته میشود.
۶. دو چالشی که شبیه هم مینمایند، اما تفاوت دارند
این نکتهای است که بیشتر کاربران از آن مطلع نیستند: «تایپ کردن با صدا» و «تبدیل یک فایل ضبطشده به متن» از لحاظ فنی دو مشکل متمایز هستند.
در حالت همزمان، مدل باید در لحظه تصمیمگیری کند. زمانی که کلمهای بیان میشود، مدل هنوز نمیداند جمله در نهایت چگونه به پایان میرسد، بنابراین نمیتواند با اتکا به ادامه جمله ابهام همآواها را برطرف کند. محدودیت اصلی در اینجا، زمان تأخیر است: اگر متن با دو ثانیه تأخیر نمایش داده شود، تجربه کاربر آسیب میبیند. به همین دلیل بیشتر ابزارهای دیکته زنده ابتدا متنی موقت نشان میدهند و پس از تکمیل جمله آن را تصحیح میکنند.
در مورد فایلهای ضبطشده این محدودیت وجود ندارد. تمام صدا از پیش موجود است، بنابراین مدل قادر است بافت کامل جمله را مشاهده کند و تصمیماتی دقیقتر بگیرد. مزیت دیگر این است که فایل را میتوان به بخشهای کوچکتر تقسیم کرده و بهصورت همزمان پردازش کرد.
نمونه ایرانی: آی او تایپ و چگونگی مدیریت این چالشها
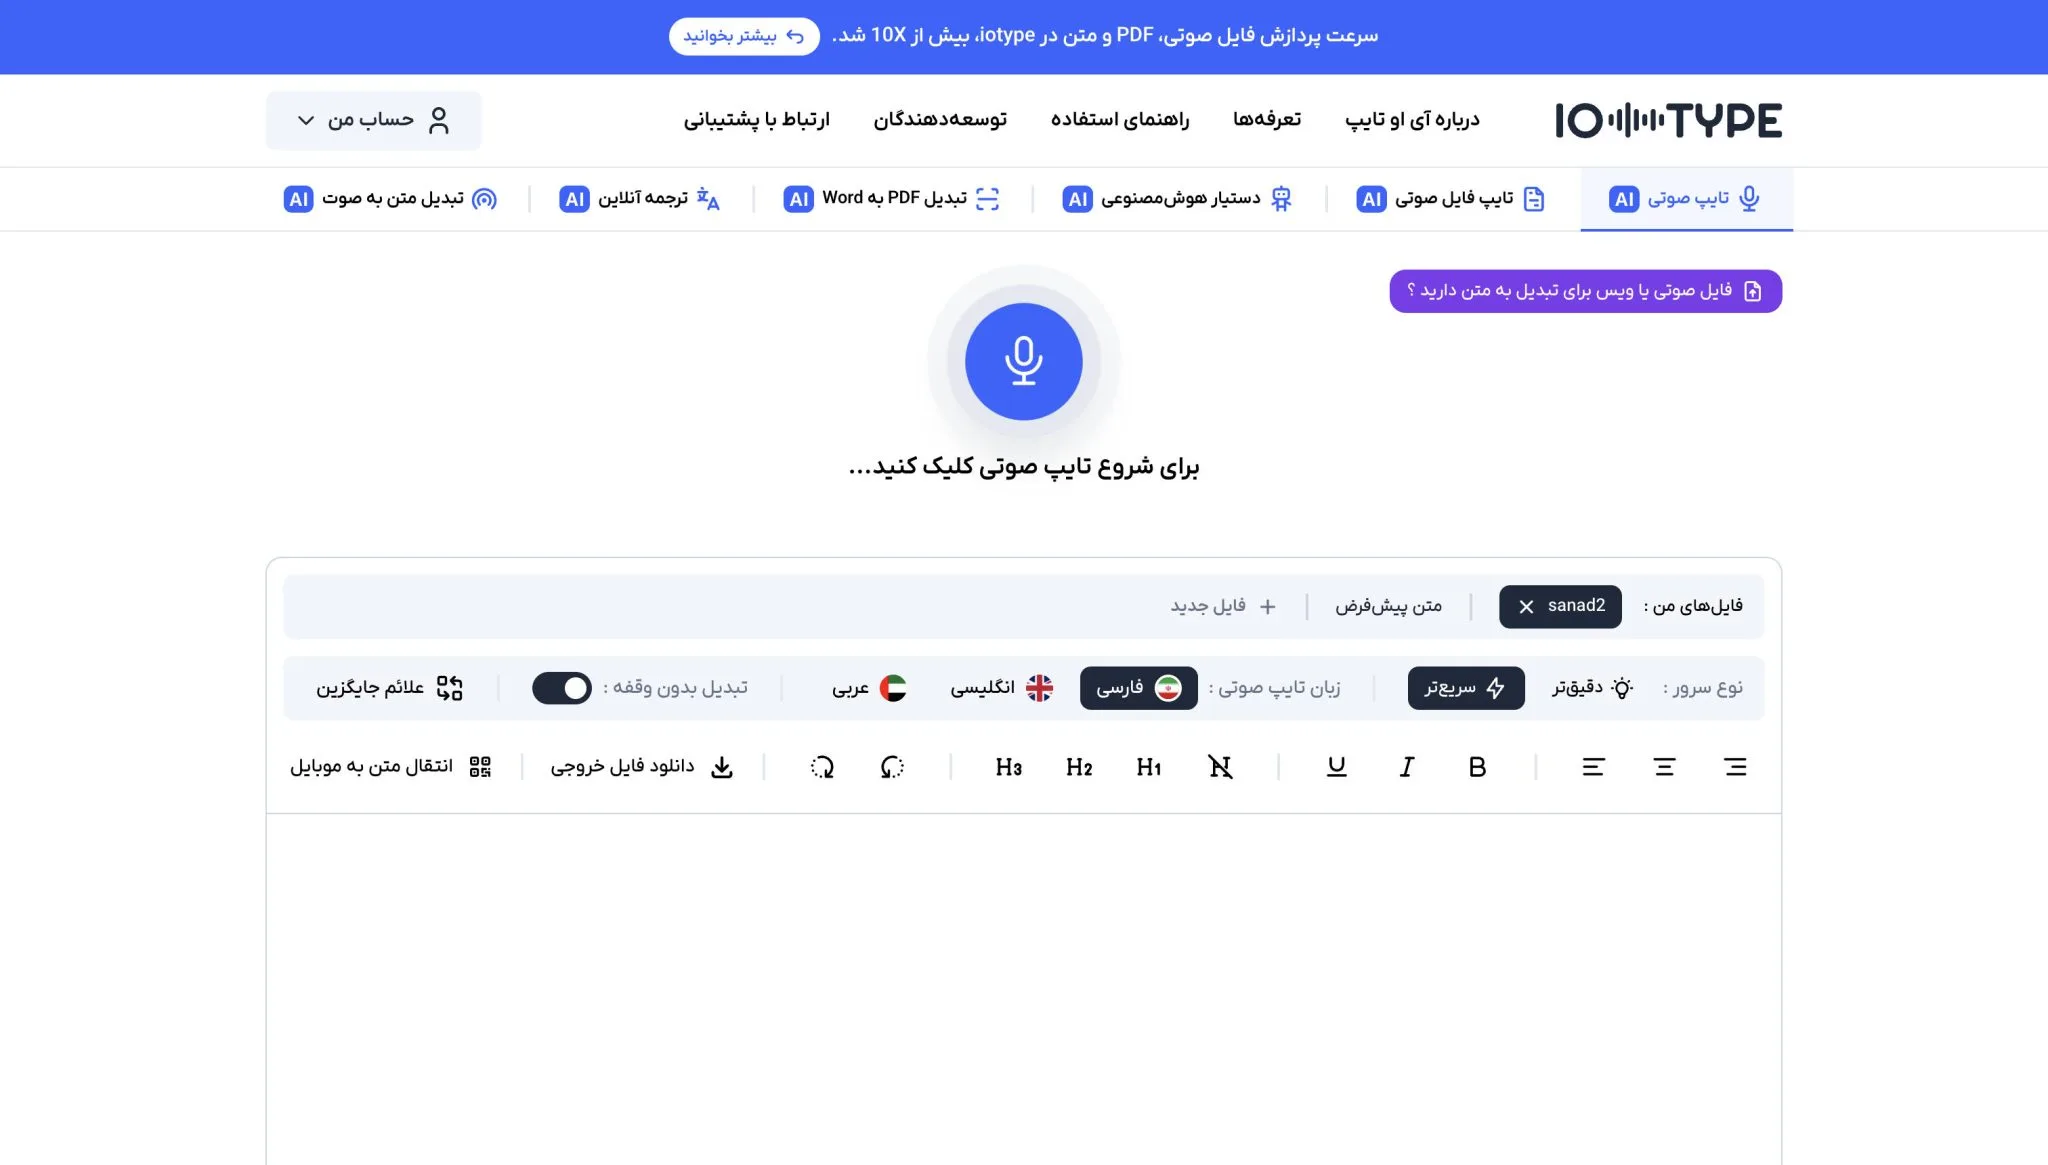
جالب است که ببینیم یک سرویس فارسی چگونه به هر یک از این چالشها پاسخ داده است. آی او تایپ که از سال ۱۳۹۶ بر روی تشخیص گفتار فارسی کار میکند، نمونهای است از این موارد که برای هر یک از شش موضوع مطرحشده راهحلی پیدا کرده است.
برای کدگردانی و واژگان تخصصی، این سیستم بخشی به نام «علائم و واژگان جایگزین» دارد: کاربر میتواند یکبار مشخص کند که اگر گفت «میکروبشناسی»، نرمافزار باید واژه microbiology را تولید کند. این روش همچنین مختص علامتگذاری نگارشی است؛ با گفتن «نقطه ویرگول»، علامت «؛» به متن اضافه میشود. این قابلیت بهویژه در متون پزشکی، حقوقی و فنی اهمیت بالایی دارد، چراکه یک اصطلاح نادرست میتواند کل سند را بیارزش کند.
برای حل موضوع کممنبع بودن فارسی، بر یادگیری از خود کاربر تکیه شده است. هرچه کاربر بیشتر از سرویس استفاده کند و خطاهای موجود در ویرایشگر را اصلاح کند، دقت تشخیص صدا، لهجه و واژگان حوزهای او افزایش مییابد — به همین ترتیب تجربه کاربری در روز اول و ماه سوم بهمراتب متفاوت خواهد بود. این سیستم از سه زبان فارسی، انگلیسی و عربی نیز پشتیبانی میکند.
و یک چالش معکوس: همان ابهامی که در تبدیل از صوت به متن وجود دارد، در تبدیل متن به صوت از سوی دیگر بروز میکند. زیرا زبان فارسی صدادارهای کوتاه را بهصورت مکتوب نشان نمیدهد و بنابراین کلمه «مهر» میتواند هم بهصورت «مِهر» و هم «مُهر» نوشته شود، و موتور تولید صدا باید پیش از خواندن آن تصمیم بگیرد که کدام نسخه صحیح است. آی او تایپ برای حل این مشکل، یک مرحله اعرابگذاری خودکار به ابتدای فرآیند تبدیل متن به صوت افزوده است.
در خصوص تفاوتهای گفتار زنده و ضبطشده، دو مسیر مجزا تعریف شده است. در سرویس تبدیل فایل صوتی به متن، فایل به بخشهای تقریبی ۱۰ دقیقهای تقسیم و بهطور همزمان پردازش میشود. نکته مهم در این است که برش در نزدیکی پایان جمله انجام گیرد تا از برش در وسط یک کلمه جلوگیری شود.
نتیجه این پردازش موازی، کاهش زمان تبدیل یک فایل ۱۰۰ دقیقهای از ۲۲ دقیقه به ۱ دقیقه و ۵۰ ثانیه بوده است. این اندازهگیریها در تاریخ ۲۱ مهر ۱۴۰۵ بر روی یک فایل مشابه انجام شده؛ یک بار با قابلیت پردازش موازی غیر فعال و یک بار فعال. زمان واقعی برای هر کاربر همچنین به ظرفیت همزمان سرور در زمان بارگذاری بستگی دارد.
برای ارزیابی نیازی به پرداخت هزینه نیست: تایپ زنده تا ۲۰۰ کلمه بهصورت رایگان ارائه میشود که هر ۱۵ دقیقه بهروز میشود و برای فایلهای ضبطشده، ۵ دقیقه ابتدایی بهصورت رایگان در دسترس است.
نقش خود ما در این فرآیند
بخشی از اشتباهات به زبان و مدل مربوط میشود. اما بخش عمدهای از آن ناشی از کیفیت ورودی است — که بهطور کامل تحت کنترل ماست:
فاصلهای که به تدریج کاهش مییابد
ده سال پیش، تبدیل گفتار فارسی به متن بیشتر بهعنوان یک نمایش فنی محدود بود تا ابزاری کاربردی. اما امروز، دانشجویی که در حال نوشتن مصاحبه پایاننامهاش است یا وکیلی که لایحهاش را با صوت ضبط میکند، به این ابزارها تکیه کردهاند.
با این وجود، تصور دقت «صد در صد» هنوز واقعبینانه نیست. زبان فارسی با داشتن دهها جفت همآوا، تفاوت بین گفتار و نوشتار، نبود رسمالخط ثابت و ادغام دائم با زبان انگلیسی، چالشهای بیشماری به همراه دارد. هر یک از این موارد بهتنهایی میتواند مسئلهای حلنشده در پردازش زبان طبیعی باشد.
واقعبینانهترین دیدگاه این است: ابزارهایی مانند تایپ صوتی آی او تایپ کارهای مکانیکی و کسلکننده را کمهزینه میکنند، ولی مرحله بازخوانی کماکان ضروری است. یک ویرایش دهدقیقهای بر روی متنی که ماشین در مدت دو دقیقه آماده کرده، همچنان از سه ساعت تایپ دستی به مراتب کمتر هزینه خواهد داشت.